

Copybara: как мы улучшили парсинг RSS и категорий
В сентябрьском обновлении Copybara мы доработали сбор контента из двух привычных источников: RSS-лент и страниц категорий. Изменения затрагивают логику парсинга, что напрямую влияет на качество черновиков. По RSS-лентам уточнили обработку элементов: заголовки, описания и ссылки на материалы теперь подхватываются корректнее. В результате при импорте заметно меньше «пустых» записей или обрезанных фрагментов, которые раньше приходилось отбрасывать […]

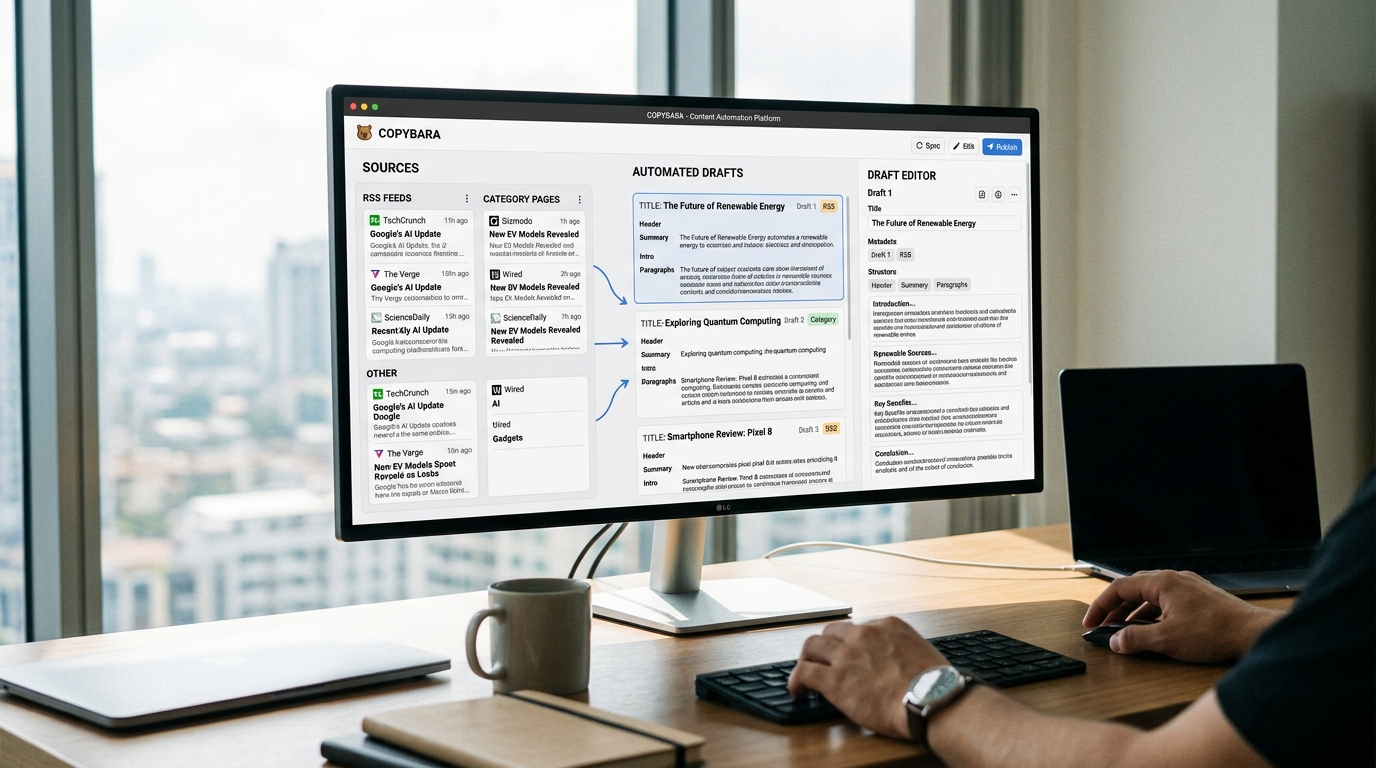
В сентябрьском обновлении Copybara мы доработали сбор контента из двух привычных источников: RSS-лент и страниц категорий. Изменения затрагивают логику парсинга, что напрямую влияет на качество черновиков.
По RSS-лентам уточнили обработку элементов: заголовки, описания и ссылки на материалы теперь подхватываются корректнее. В результате при импорте заметно меньше «пустых» записей или обрезанных фрагментов, которые раньше приходилось отбрасывать вручную.
Со страницами категорий тоже стало предсказуемее. Парсер лучше находит списки публикаций и корректно переходит к полным текстам. Это помогает, когда сайт-источник не отдаёт контент через RSS, а публикует материалы в рубриках. Теперь такие разделы обрабатываются стабильнее.
Для пользователя итог простой: из тех же источников получается больше пригодных черновиков, а ручной чистки перед рерайтом становится меньше. Подключите ленту или страницу категории и сравните качество сбора с прежним результатом.